Flagowiec czy model podręczny? Kiedy wybrać do pracy mocniejszy model AI
28 września 2026 · Grzegorz
Użytkowników AI można spróbować podzielić na dwie grupy. Jedni do wszystkiego używają najmocniejszego modelu, jaki mają w abonamencie. Bo mogą. Drudzy trzymają się najtańszego. Bo działa. Pierwsza opcja powoduje szybkie zjadanie limitów tokenów i czasów sesji. Druga często obniża jakość, co wychodzi na jaw dopiero przy kolejnej poprawce tego samego wyniku.
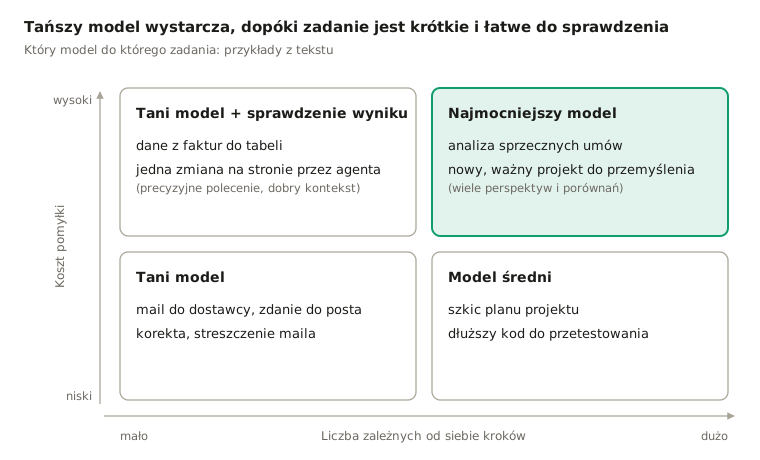
Wybór między flagowcem a modelem podręcznym nie zależy od tematu rozmowy (analiza ekonomiczna, redagowanie tekstu, budowanie wykresu itp.). Zależy od dwóch rzeczy: ile kroków musi wykonać model i na ile kosztowna może być jego pomyłka.
Liczy się całkowity koszt zadania, nie cena tokenu
Każdy duży producent ma dziś co najmniej trzy klasy modeli: flagowca, model średni i model szybki. Ceny między klasami różnią się znacznie, a u każdego producenta inaczej. Aktualne ceny modeli Anthropic, OpenAI, Google i innych producentów zestawiłem w porównywarce Hallny.
Nawet jeśli płacisz abonament, a nie za tokeny pay-per-use, te liczby i tak cię dotyczą. Szybciej osiągasz limit, pomimo faktu, że zużycie tokenów w abonamencie jest liczone inaczej – laby je dotują. Anthropic w swoim centrum pomocy wymienia wybór modelu i poziom wysiłku wśród czynników, które decydują o tym, jak szybko limit się wyczerpuje.
Z mojej praktyki: wszystko zależy od zadania. Jeśli agent ma wprowadzić jedną konkretną zmianę na stronie internetowej, na przykład dodać nowy element, a ja daję mu precyzyjne polecenie i dobry kontekst, używam taniego modelu. Jeśli robię coś naprawdę ważnego i nowego, co ma być dogłębnie przemyślane, a model ma rozważyć kilka perspektyw, porównać warianty i przeanalizować sprawę z różnych stron, wybieram droższy. Inny model do pracy trudnej, inny do rutynowej.
Tańszy model odpowiada szybciej i taniej. Mocniejszy pracuje dłużej i kosztuje więcej, ale przy trudnym zadaniu rzadziej wymaga poprawek.
Anthropic na swoim blogu pisze, że „koszt w przeliczeniu na zadanie jest często niższy w przypadku inteligentniejszych modeli”, mimo wyższej ceny za token, bo mocniejszy model potrzebuje mniej prób. Jeżeli słabszy model trzy razy oddaje wynik, który mnie nie zadowala, a mocniejszy trafia za pierwszym razem, oszczędności brak.
OpenAI rozkłada akcenty inaczej. W materiałach OpenAI Academy, przy okazji wyboru między zwykłym modelem a trybem rozumowania, czytamy, że „do większości zadań w pracy, takich jak redagowanie dokumentów, streszczanie czy analiza danych, właściwym punktem wyjścia jest model bez rozumowania”.
Tańszy model zwykle wystarcza, gdy zadanie jest krótkie, powtarzalne i łatwe do sprawdzenia: streszczenie maila, korekta tekstu, tłumaczenie prostej wiadomości, przypisanie zgłoszeń do kategorii, wyciągnięcie danych do tabeli. Mocniejszy zaczyna się opłacać, gdy kroków jest wiele i zależą od siebie: analiza sprzecznych dokumentów, plan projektu z zależnościami, dłuższy kod, praca, w której model sam wykonuje kolejne czynności. Anthropic opisuje to podobnie: Opusa poleca do złożonego rozumowania, zaawansowanego programowania i pracy agentowej, a szybkiego Haiku do dużej liczby prostych zadań i sytuacji, w których liczy się czas odpowiedzi.
 Powiększ
Zlecenie nieskomplikowanego maila do dostawcy lub zdanie do posta na LinkedInie nie wymaga flagowca tylko dlatego, że dotyczy ważnego klienta. Analiza trzech umów raczej go wymaga, nawet jeśli nie chodzi o kluczowego kontrahenta.
O wyborze modelu nie decyduje temat rozmowy, tylko liczba kroków i potencjalny koszt pomyłki.
Od którego modelu zacząć
 Powiększ
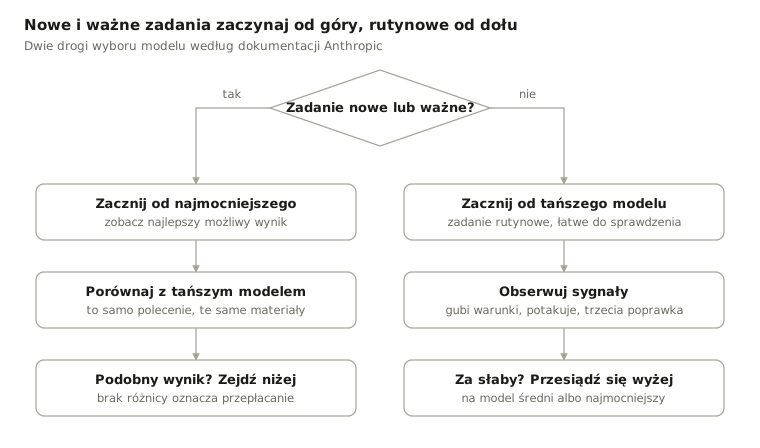
Dokumentacja Anthropic proponuje dwa podejścia i oba dobrze przekładają się na codzienną pracę w aplikacji AI. Pierwsze zaczyna od modelu szybkiego i przesiada się na mocniejszy dopiero wtedy, gdy wynik nie wystarcza. Pasuje do zadań powtarzalnych, które robisz wiele razy i których wynik łatwo ocenić. Drugie zaczyna od najmocniejszego modelu i schodzi niżej, jeśli tańszy daje porównywalny efekt. Ma sens przy zadaniu nowym, ważnym albo takim, o którym nie wiesz jeszcze, jak trudne jest naprawdę. Najpierw patrzę, jak wygląda najlepszy możliwy wynik, potem sprawdzam, czy tańszy model się do niego zbliża. Bez takiego punktu odniesienia łatwo uznać przeciętną odpowiedź (tekst, wykres itp.) za dobrą.
Kiedy przesiąść się na wyższy model? Kilka sygnałów powtarza się niezależnie od producenta. Model gubi warunki, które podałeś w poleceniu, zapomina wziąć pod uwagę fragmenty kontekstu. Odpowiedź brzmi niby przekonująco, ale po sprawdzeniu nie broni się. Poprawiam ten sam wynik po raz trzeci, a model za każdym razem potakuje mi i przyznaje się do błędu, po czym popełnia nowy błąd. W dłuższej pracy zapomina ustalenia sprzed kilku kroków.
A kiedy z kolei przesiąść się na niższy model? Na odpowiedź na proste pytanie czekam dłużej, niż zajęłoby mi znalezienie jej samemu. Limit kończy się w połowie dnia, choć nie robiłem niczego skomplikowanego. Porównuję wyniki obu modeli i nie potrafię wskazać różnicy.
Jeśli nie widzę różnicy między odpowiedzią tańszego i droższego modelu, przepłacam.
Trzeba być elastycznym. Można przygotować wstępną wersję szybkim modelem, a mocniejszego poprosić tylko o sprawdzenie. Na podobnym pomyśle Anthropic oparł wiosną 2026 roku tzw. strategię doradcy: tańszy model wykonuje pracę, a droższy włącza się dopiero przy trudnych decyzjach. O łączeniu modeli napiszę osobny tekst.
Źródła
Nazwy modeli według stanu na 28 września 2026 roku.
- Anthropic, Claude models explained: choosing the best model for your use case, lipiec 2026
- Anthropic, Choosing the right model, dokumentacja
- Anthropic, How do usage and length limits work?, centrum pomocy
- Anthropic, The advisor strategy, kwiecień 2026
- OpenAI Academy, Models, aktualizacja z maja 2026